清华大学电子工程系与 RoboChallenge 联合发起首个面向四足机器人的具身视觉—语言导航(Vision-and-Language Navigation,VLN)基准赛事。
RoboChallenge作为由原力灵机与 Hugging Face 联合发起的全球首个大规模的真机评测平台,自成立以来,完成了数万次严苛远程真机测试,以大规模、标准化、可复现的数据,客观揭示了当前视觉-语言-动作模型在真实物理环境中的能力边界与共性挑战,为具身智能(Embodied AI)从实验室迈向通用化,提供了不可或缺的“公正标尺”与行动指南。
在推出table 30系列benchmark后,Robochallenge再度与清华大学电子工程系推出全球首个VLN Benchmark。
通过标准化任务、统一评测协议、评分机制、真实四足机器人远程评测和持续更新的官方排行榜,赛事将为研究者与开发者提供一个开放、可比较、可复现的具身智能评测平台,推动导航模型从仿真训练走向真实世界验证。
当导航开始受到“身体”的约束
视觉—语言导航研究试图回答一个重要问题:机器人能否根据自然语言指令理解环境,并自主到达指定目标?
在许多传统 VLN 任务中,导航主体通常被抽象为一个移动相机或导航点。模型主要学习语言、视觉观测和路径之间的对应关系,却较少面对真实机器人在移动过程中受到的身体约束。
但在真实世界里,“看见一条路”和“能够通过这条路”并不是同一件事。
面对狭窄通道,机器人需要判断机身宽度和转弯空间;面对低矮入口,它需要降低身体姿态并避免机身与传感器发生碰撞;面对楼梯、碎石、窄梁和离散落脚点,它还需要考虑步态切换、足端位置、重心变化和机身稳定性。
同一条路径,对不同形态、不同尺寸和不同运动能力的机器人而言,可能具有完全不同的可通行性。
因此,真实机器人的 VLN 不能只回答“应该往哪里走”,还必须进一步回答:
以我的身体,能不能这样走?应该用什么方式通过?
从路径导航走向本体感知的行为级导航
本次赛事将评测重点从以相机轨迹为中心的导航,推进到本体约束下的行为级导航。
参赛模型需要理解自然语言中的目标、方向、空间关系、动作要求和安全约束,并将这些信息与机器人感知到的环境结构进行对应。在此基础上,模型还需要结合机器人的机身高度、宽度、足端可达范围、步态能力、转弯半径和稳定裕度,生成能够被真实四足机器人执行的导航策略。
赛事不以单纯竞速为目标,而是更加关注参赛模型与机器人系统能否:
• 正确理解自然语言中的目标、动作和约束;
• 感知环境的距离、高度、宽度、坡度和支撑关系;
• 判断环境结构是否符合机器人的物理通行条件;
• 根据场景选择合适的姿态、步态和足端落点;
• 在任务执行过程中避免碰撞、踩空、跌落和失稳;
• 在长程任务中持续分解目标、选择路线并组合不同技能。
十项原子任务,拆解真实导航的关键能力
为了让不同能力得到独立、清晰和可比较的评测,赛事将设置十项原子任务。每项任务对应具身导航中的一种关键能力,并配套统一的任务定义、评测流程和与任务目标相匹配的评分机制。
目前Robochallenge官网已更新四项任务:
P1
常规短指令目标导航
机器人根据简短的自然语言指令,在低复杂度环境中找到指定视觉目标,并在正确位置稳定停止。
P2
曲折狭窄通道导航
机器人需要沿连续弯折或 S 型狭窄通道前进。模型需要根据机身宽度、转弯半径和侧向安全空间持续调整路线,使机器人在不接触周围墙体的情况下完成通过。
P3
楼梯上下导航
模型需要识别楼梯结构及通行方向,为机器人选择适当的运动方式,使其稳定完成上楼或下楼,并到达指定目标区域。
P4
低矮墙洞钻越导航
模型需要判断低矮入口是否可通行,控制机器人自主降低身体姿态,在避免机身和传感器碰撞的情况下穿过洞口,并在通过后恢复正常姿态。
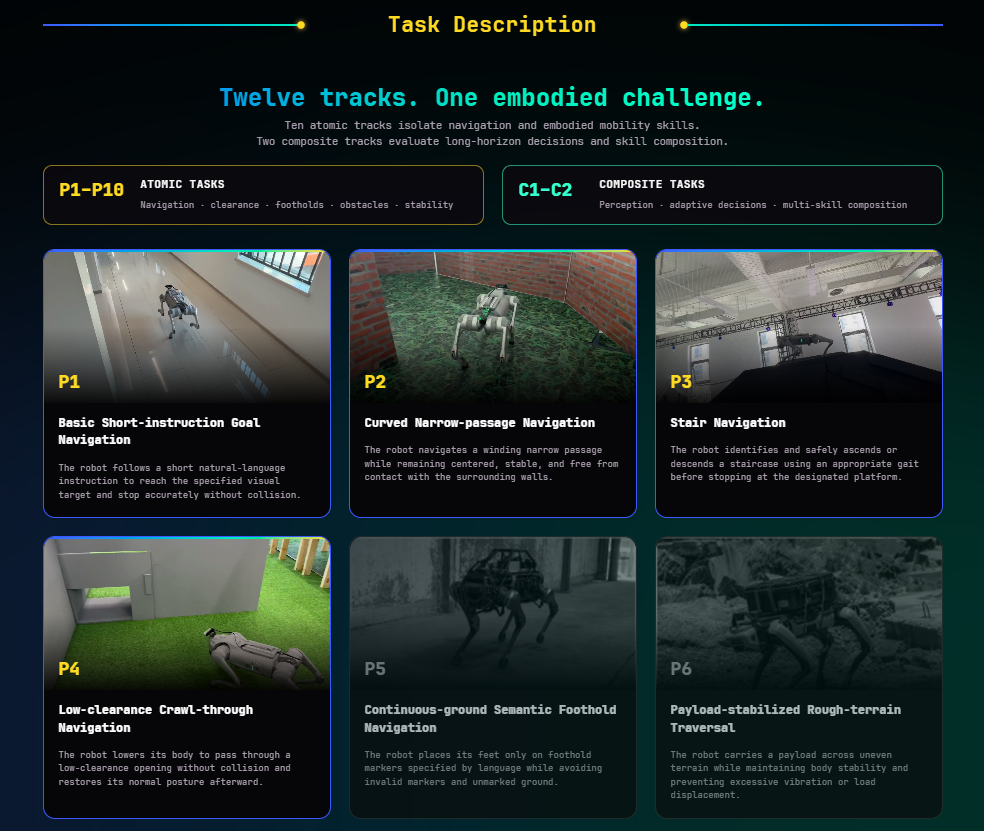
这些任务将模型的语言理解、环境感知和决策能力,与真实机器人的运动能力放入同一评测体系,使研究者能够更准确地判断一套具身导航系统的能力边界:它究竟是不理解指令、没有正确感知环境、作出了错误决策,还是无法将决策转化为符合本体约束的实际行动。
未来在Robochallenge官网将持续更新剩下的赛题,敬请期待......
从原子能力走向长程任务组合
真实环境中的导航任务往往不会以彼此独立的形式出现。
机器人可能需要先穿过狭窄区域,再上下楼梯;也可能需要跨越障碍、经过离散落脚区域,最后在复杂地形中寻找目标。任务顺序、环境参数和可选路线都可能发生变化,参赛模型不能只依赖固定路线或预设脚本完成比赛。
为此,赛事还将设置两项复合任务:
C1 混合地形导航
机器人需要在碎石、积水、裂缝、窄支撑和障碍物等多种地形共同构成的环境中完成导航。模型需要识别安全可通行区域,自主选择路线,并根据地形变化持续调整机器人的步态与身体姿态。
C2 长程复合任务导航
模型需要理解长程自然语言任务,自主识别不同任务阶段,将整体目标分解为多个子目标,并根据实时环境选择和组合相应的导航技能,最终控制机器人安全到达指定区域。
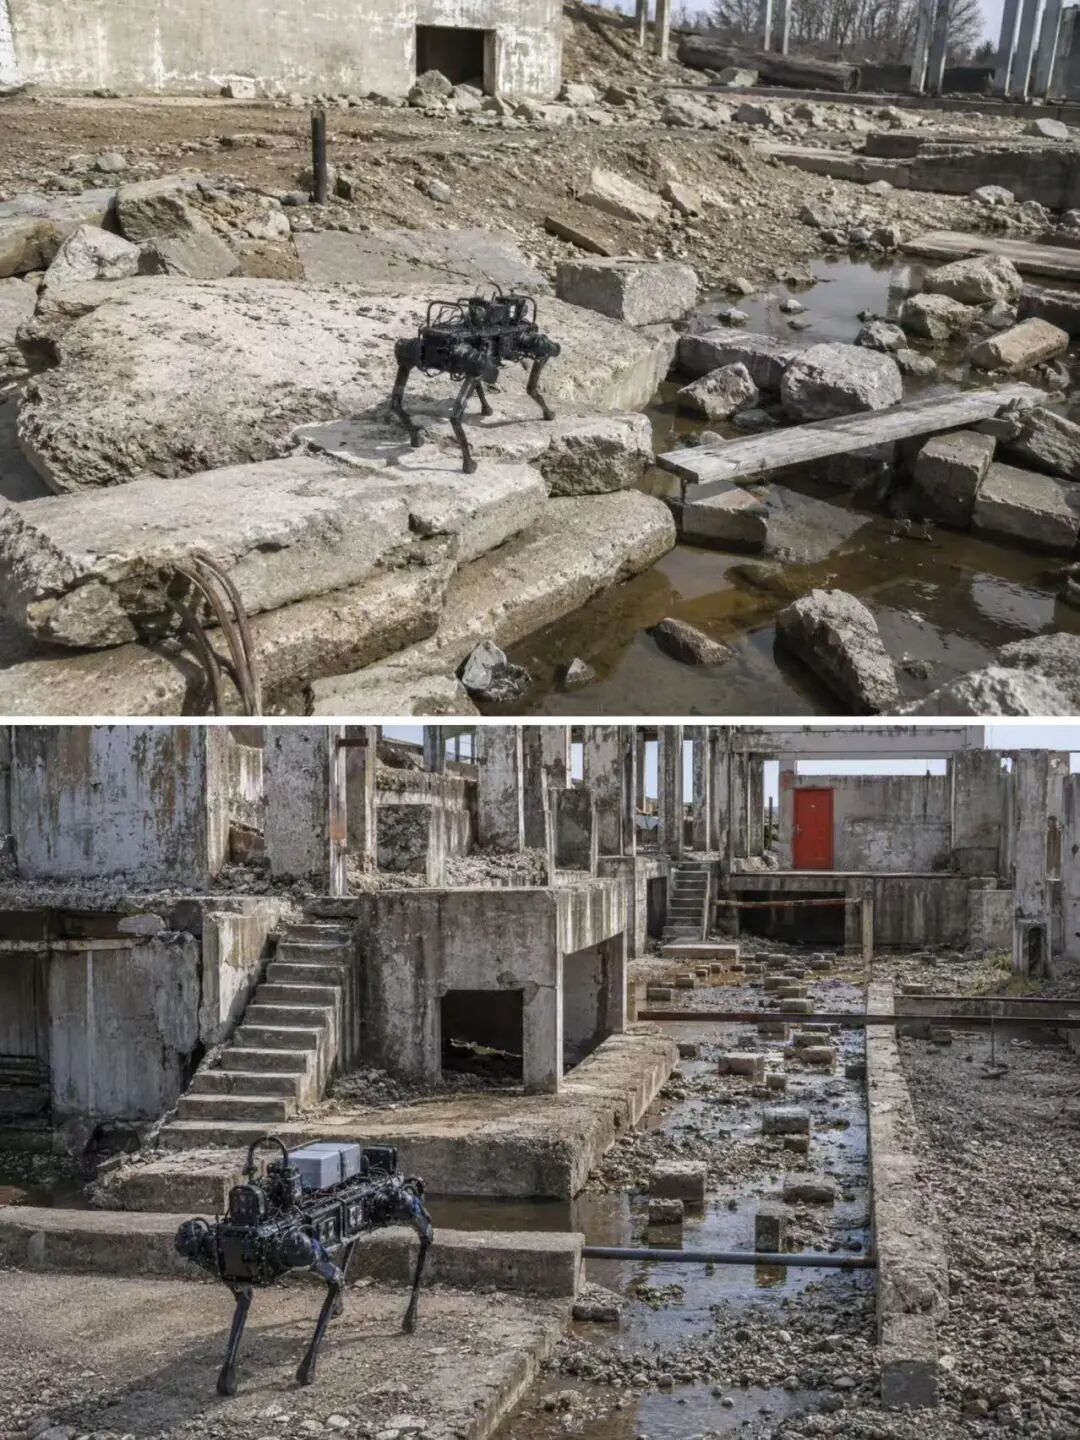
相比单项任务,复合任务更关注参赛模型能否把已经具备的能力组织起来:在未知或变化的任务顺序中判断当前处境、选择下一步行为,并在持续执行中同时满足语言约束和物理约束。
这也是赛事从“单项障碍通过能力测试”走向具身视觉—语言导航 Benchmark 的关键一步。
让模型在真实机器人上接受检验
真实机器人的开发和评测通常面临设备成本高、场地资源有限、实验条件难以统一等问题。不同团队使用不同硬件、不同环境和不同评测方法,也使模型结果难以直接比较。
针对这一问题,清华大学电子工程系与 RoboChallenge 将共同建立覆盖任务定义、模型提交、仿真测试、真实机器人运行、结果验证和榜单发布的评测流程。
参赛团队可通过远程接入真实四足机器人开展任务评测。所有参赛模型将按照统一协议运行和验证,使不同团队的技术方案能够在相同机器人平台、相同任务条件和相同评分框架下进行比较。
经过统一流程验证的成绩将持续更新至官方排行榜,为研究社区提供公开、透明且可追踪的模型能力参照。
一个持续开放 Benchmark
本次赛事不是一次性的集中评比,而是一个将持续更新的开放 Benchmark。
十项原子任务和两项复合任务将分赛段开放。目前Robochallenge网站已更新四个赛题。
随着评测体系不断完善,仿真资产、baseline和相关数据资源也将按计划陆续发布。研究团队可以从单项能力入手,逐步完成模型训练、问题诊断、仿真测试和真实机器人验证,再向混合地形与长程任务发起挑战。
官方排行榜将随评测进程持续更新,记录经过统一流程验证的模型表现。
通过这一机制,赛事希望建立一条从模型研究到系统验证、从仿真训练到真实执行、从单项能力到长程任务的持续迭代路径。
面向真实世界,重新定义机器人导航
具身智能最终需要进入物理世界,在真实环境中理解任务、作出判断并完成行动。
清华大学电子工程系与 RoboChallenge 希望通过本次赛事,为具身视觉—语言导航建立更加标准化、可复现和面向真实机器人的评测基础,推动语言理解、环境感知、导航决策和机器人运动控制之间形成更紧密的连。
关于赛题的更多信息,将持续更新在Robochallenge官网: https://robochallenge.ai/competition/quadruped-vln
供稿|电路与系统研究所
审核|余潇潇 沈 渊 李 洪